Token不够用?学会这三招立马节省
具体如何省钱,要从三层下手:选模型、选计费、改操作。
拓扑森林学习社区里,同学们经常会提出一些问题,有代表性、经常提及的问题,整理成“导师答疑”,方便同学们查看。
如何让Token花小钱办大事
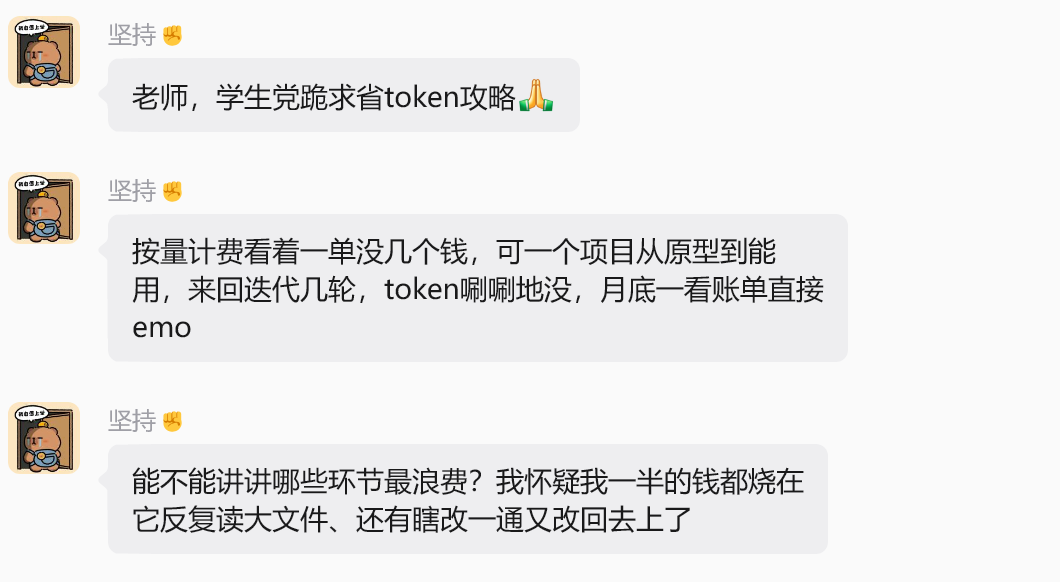
钱确实烧在你猜的那两个地方,但更大的火苗是计费机制本身——按量计费下,每一轮对话都要把整个会话上下文重新计费一遍。
你聊到第 20 轮、上下文积累到 10 万 token 时,哪怕只问一句“按钮换个颜色”,这 10 万 token 也要全量重发重计费。
先看Token使用报告
有很多计算Token的开源项目,让AI智能体自己去找一个靠谱的安装就行。
安装后直接可以用,出一份你自己的Token使用报告。
看报告一切都清楚了,直接能看到哪些窗口是最耗Token的。
只有清楚了你自己的Token账单,才知道应该如何省。
具体如何省钱,要从三层下手:选模型、选计费、改操作。
模型选择——多模型搭配使用
同样写出海 SaaS 的代码,国外旗舰模型的 token 单价大概是国内主流模型的 3~6 倍,而智谱、Kimi 的最新版本,写业务代码的可用性和国外模型已经没什么实质差别。
第一刀从这里砍。
计费方式——别裸用按量,上 coding plan
以智谱为例,coding plan 折算下来 100 万 token 约 1 元,基本是按量单价的 1/6 到 1/10。
操作习惯——六条立省
1、无关联的任务,开独立窗口。
原理就是开头说的:每轮按全量上下文计费。A 任务和 B 任务混在一个窗口里,B 的每一轮都在替 A 的历史付费。独立窗口 = 计费基数干净。
2、长任务跑几轮就“打包搬家”。
执行几次后,把这段提示词发给 AI:
请把当前会话整理成一份交接总结:1)任务目标和背景;2)已完成的内容和关键文件路径;3)重要决策及原因;4)当前进行到哪一步;5)已知问题和下一步计划。写给下一个接手的 AI 看,控制在 500 字以内。
然后开新窗口贴进去,说一句“基于以上总结继续执行”,任务无缝继续。
相当于把几万 token 的历史压缩成几百 token 的现场,新窗口从摘要起步,不从全量历史起步。
3、规则、技能用“匹配生效”,MCP 只留常用的。
原理:规则文件、技能描述、MCP 工具目录是每轮固定注入的“头部 token”——不管你问什么,这部分先计费。
规则设成命中场景才生效,MCP 从 20 个砍到 5 个,等于直接砍掉固定开销。
4、模型分层。
长任务、复杂架构用旗舰版本。
修 bug、改文案、小调整用 flash 版本,单价差好几倍。
5、错峰跑长任务。
很多模型在闲时(深夜到清晨)有折扣,批量重构、大规模生成这类长活儿扔到闲时跑,同样的 token 花更少的钱。
6、盯促销。
平台经常有充值赠送和折扣,比如 ZCode 就有过赠送充值额度和 0.6 折的活动,囤额度要趁这种时候。
这波省下来的总账: 模型层省 3~6 倍,计费层再省 6~10 倍,操作习惯层再省 30%~50%。
叠起来,同一个从原型到能用的项目,成本能压到原来的几十分之一,emo 直接治愈。
如果你也想通过Vibe Coding做网站出海变现,欢迎加入拓扑森林社区。